Een beschrijving die geen filter kan uitdrukken, maak je tot een lijst door haar te splitsen in attributen die een database bevat en bewijs dat alleen een realtime bron toont.
Kort samengevat
- In een gids uit 2026 noemt Merit Data, een B2B-dataleverancier, branche, bedrijfsgrootte en functietitel "noodzakelijk maar bij lange na niet voldoende" om een ICP te bepalen.
- De API-referentie van Apollo, gelezen op 23 september 2026, filtert bedrijven op functietitels in actieve vacatures, gebruikte technologieën en de datum van de laatste financieringsronde. Geen enkel veld bevat een voorwaarde als "eerste verkoper".
- Het helpcentrum van LinkedIn, gelezen op 23 september 2026, stelt dat een doelgroep minstens 300 ledenaccounts moet matchen voordat een advertentieset hem kan gebruiken.
- Een benchmark van een bureau uit mei 2026 meldt 90 tot 98 procent match voor bedrijfslijsten met naam en domein, terwijl een gids uit maart 2026 60 tot 85 procent geeft voor bekende bedrijven.
- De statistieken van Cleanlist voor 2026 zetten het verval van B2B-contactgegevens op ongeveer 2,1 procent per maand. In dat tempo heeft een lijst die 90 dagen voor de verzending is gemaakt ongeveer 6,2 procent van haar nauwkeurigheid verloren.
- Lusha telde tussen januari en juni 2026 wereldwijd 1.470.414 bedrijfswissels, ongeveer 13.600 contacten die elke werkdag van baan wisselen.
Waarom kan een databasefilter geen campagnebriefing uitdrukken?
De meeste filters beschrijven wat een bedrijf is, terwijl een echte briefing meestal draait om iets wat het bedrijf onlangs heeft gedaan. Databases filteren inmiddels op een paar gedragingen, zoals werving en financiering, maar de voorwaarde waar de campagne om draait, zoals een eerste verkoper of een tweede vestiging, heeft zelden een eigen veld.
Marketeers beschrijven het segment dat ze willen in één zin en ontdekken dan dat het filterpaneel er geen veld voor heeft. Merit Data, een B2B-dataleverancier, zegt het duidelijk in een gids uit 2026. Branche, bedrijfsgrootte en functietitel zijn "noodzakelijk maar bij lange na niet voldoende". Dezelfde gids laat dat zien met twee bedrijven die hetzelfde firmografische profiel hebben, waarvan het ene met budget aan het evalueren is en het andere de komende achttien maanden niet koopt.
De betere databases dekken inmiddels ook een deel van het gedrag. De organisatiezoekfunctie van Apollo filtert bijvoorbeeld op functietitels in actieve vacatures, de publicatiedatum van vacatures, gebruikte technologieën en de datum van de laatste financieringsronde. Wat geen enkel filterpaneel bevat, is de specifieke voorwaarde waar je briefing om draait (een eerste verkoper in plaats van zomaar een verkoper, een tweede vestiging, advertenties zonder werkende webwinkel).
Ook de grote dekkingscijfers geven geen uitsluitsel. Een overzicht van Landbase uit januari 2026 schrijft meer dan 360 miljoen bedrijven in 220 landen en gebieden toe aan InfobelPRO, en een nauwkeurigheid van meer dan 95 procent op contactgegevens aan ZoomInfo. Het eerste cijfer telt entiteiten en het tweede is een kwaliteitsclaim over de gegevens van één leverancier. Geen van beide zegt hoeveel bedrijven bij je briefing passen.
Hoe vind je bedrijven op wat ze doen in plaats van wat ze zijn?
Zoek niet naar een filter, maar naar de plek waar het gedrag openbaar zichtbaar wordt. Ontleed de beschrijving voorwaarde voor voorwaarde, deel elke voorwaarde in als attribuut of als bewijs, en noteer het type bron dat haar toont en hoe snel dat signaal veroudert.
"Bedrijven die onlangs een tweede vestiging hebben geopend." "Bedrijven die hun eerste verkoper aannemen." "Bedrijven die adverteren zonder werkende webwinkel." Elk daarvan is een echt segment, en geen van alle is een vinkje in een filterpaneel.
Voor de attribuutrijen is een opgeslagen database gebouwd, en sommige bewijsrijen bestaan inmiddels ook als filter, in de eigen indeling van de leverancier. Buiten bereik blijven de specifieke of recente rijen, omdat een momentopname die per cyclus wordt ververst niet kan weten wat er vorige week gebeurde. Het register staat aan beide kanten van de tabel. Het bevat attributen zoals rechtsvorm en branche, en het legt ook gedateerde gebeurtenissen vast zoals oprichting en deponeringen.
Werk eerst de bewijsrijen af. Ze zijn kleiner, ze geven je een reden om te schrijven en ze brengen de lijst meestal terug tot een omvang die een campagne echt aankan. Tools die realtime bronnen bevragen in plaats van een momentopname te filteren, bespreken we in ons overzicht van AI-prospectingtools.
Hoe maak je een lijst als geen enkel filter het juiste woord heeft?
Splits de beschrijving in twee lagen en neem hun doorsnede. De attribuutlaag bevat alles wat een filter kan uitdrukken, zo ruim mogelijk. De bewijslaag bevat een of twee gedateerde, controleerbare feiten die waar moeten zijn. De doorsnede is je lijst, meestal kleiner en veel bruikbaarder dan wat een filter oplevert.
Soms gaat de briefing helemaal niet over gedrag. Dan is het een beschrijving in gewone taal waarvoor geen enkele filterindeling een woord heeft, zoals een bedrijf dat andere bedrijven op een bijzondere manier bedient, of een bedrijf in een specifieke fase van het opbouwen van een functie.
De attribuutlaag is alles wat een filter kan uitdrukken, en die maak je zo ruim als je kunt verantwoorden. Elk extra filter verkleint de pool voordat de bewijslaag de kans heeft gehad iemand te kwalificeren. Een veelgemaakte fout is zes filters stapelen, op 40 bedrijven uitkomen en concluderen dat het segment niet bestaat.
De bewijslaag is een of twee gedateerde, controleerbare dingen die waar moeten zijn. Drie of vier voorwaarden zijn te veel. Eén goed bewijs per rij maakt de rij verdedigbaar tegenover een salesleider die vraagt waarom een bedrijf op de lijst staat, en het geeft de campagne ook haar openingszin.
Neem dan de doorsnede. Ruime attributen met strikt bewijs leveren een lijst op die kleiner is dan het filterpaneel deed vermoeden, en veel werkbaarder. Strikte attributen zonder bewijs leveren een lijst op die nauwkeurig oogt, maar in de praktijk een gok is. Rond precies zo'n briefing is onze pagina voor marketingteams opgebouwd.
- Een briefing in één zin
- Een ruime attribuutlaag
- Een of twee gedateerde feiten
- Een telling per voorwaarde
- De doorsnede van beide lagen
- Verificatie op de verzenddag
Hoe tel je een segment voordat je aan data uitgeeft?
Tel voordat je uitgeeft. Noteer het aantal van de attribuutlaag alleen, pas daarna elke bewijsvoorwaarde afzonderlijk toe en noteer elk aantal, en pas ze vervolgens samen toe. Het eindgetal is je adresseerbare aantal, en de tussenstanden laten zien welke voorwaarde je moet versoepelen als de telling te klein uitvalt.
Als je niet weet of het segment 400 of 9.000 bedrijven bevat, kun je de omvang van de campagne niet bepalen, en ken je het antwoord pas als de factuur er is. Elke voorwaarde apart noteren laat zien welke de lijst verkleint.
Hier hoort ook de contactvraag. Een aantal bedrijven is geen aantal bereikbare mensen. Geverifieerde contacten zijn een aparte opbrengst bovenop het aantal bedrijven, en als je die stap overslaat, budgetteer je op bedrijven en voer je uit op de helft ervan. Onze gids over wat prospectingdata een salesteam kost rekent de kosten per bruikbaar contact door, het getal dat de telling uiteindelijk moet opleveren.
Waarom matcht een geüploade doelgroep zo slecht?
Meestal door het formaat van de lijst en niet door het advertentieplatform. Op LinkedIn, het platform dat we hier als referentie nemen, matchen bedrijfslijsten met naam en domein veel beter dan contactlijsten, en een doelgroep die minder dan 300 ledenaccounts matcht, kan in geen enkele advertentieset worden gebruikt.
Het helpcentrum van LinkedIn definieert het matchpercentage als het aandeel van de geüploade items dat aan een ledenaccount of, bij bedrijfslijsten, aan een LinkedIn-pagina is gekoppeld. Het zegt ook dat de website van het bedrijf of de URL van de LinkedIn-bedrijfspagina toevoegen een bedrijfslijst beter laat matchen, en dat een lijst minstens 300 ledenaccounts moet matchen voordat een advertentieset hem kan gebruiken.
De gepubliceerde percentages verschillen per bron. Een benchmark van een bureau uit mei 2026 zet bedrijfslijsten met naam en domein op 90 tot 98 procent, en contactlijsten op 70 tot 85 procent bij zakelijke e-mails, 40 tot 60 procent bij persoonlijke e-mails en 60 tot 70 procent bij gemengde lijsten. Een gids uit maart 2026 is voorzichtiger, met 60 tot 85 procent voor bekende bedrijven en 30 tot 60 procent voor contactlijsten.
Een rekenvoorbeeld maakt dat concreet. Een contactlijst van 400 personen die voor 60 procent matcht, de bovenkant van de voorzichtige bandbreedte, levert ongeveer 240 ledenaccounts op. Dat is onder het minimum van 300, dus de campagne kan niet leveren.
De praktische regel is dus om altijd het domein mee te nemen en de bedrijfsrij te behandelen als de hoofdeenheid met de contacten eraan gekoppeld, en niet andersom. De oplossing ligt eerder in het proces, in hoe de brondoelgroep wordt samengesteld, en niet in de platforminstellingen.
Hoe snel veroudert een B2B-lijst tussen samenstellen en verzenden?
Snel genoeg om er tijdens de looptijd van een campagne rekening mee te houden. De statistieken van Cleanlist voor 2026 zetten het verval van B2B-contactgegevens op ongeveer 2,1 procent per maand, of 22,5 procent per jaar. In dat tempo heeft een lijst die 90 dagen voor de verzending is gemaakt ongeveer 6,2 procent van haar nauwkeurigheid verloren voordat de eerste e-mail vertrekt.
Lijsten zijn bederfelijk en campagneplanningen zijn lang. De statistieken van Cleanlist over dataverval in 2026 geven ongeveer 22,5 procent per jaar, rond 2,1 procent per maand, vooral gedreven door 15 tot 20 procent van de professionals die elk jaar van werkgever wisselen. Hetzelfde percentage van 2,1 procent staat op de Database Decay Simulation van HubSpot, die het toeschrijft aan onderzoek van MarketingSherpa. Recentere tellingen wijzen dezelfde kant op. Het Email List Decay Report 2026 van ZeroBounce, gebaseerd op meer dan 11 miljard adressen die in 2025 zijn verwerkt, stelt vast dat minstens 23 procent van een e-maillijst binnen een jaar veroudert. Lusha registreerde tussen januari en juni 2026 wereldwijd 1.470.414 bedrijfswissels, ongeveer 13.600 contacten die elke werkdag van baan wisselen.
Bij 2,1 procent per maand, samengesteld, kost het gat tussen samenstellen en verzenden je dit.
Die getallen lijken klein genoeg om te negeren, maar zijn groot genoeg om een slecht bouncepercentage te verklaren. De oplossing is een verificatieronde op de ochtend van de verzending in plaats van op de dag van het samenstellen, wat ook het verzenddomein beschermt waarover je nurture- en lifecyclemails lopen. De richtlijnen van Instantly voor 2026 over het uploaden van lijsten zeggen het bouncepercentage op 2 procent of lager te houden en beschouwen alles daarboven als een teken van slechte lijsthygiëne. Onze gids over het verifiëren van een B2B-e-maillijst zet de controles uiteen en wat ze per duizend records kosten.
De bewijslaag veroudert sneller dan de contacten. Een financieringsaankondiging blijft wekenlang een reden om te schrijven. Een vacature blijft dat maar enkele dagen. Als de campagne een maand opschuift, zoek het bewijs dan opnieuw op in plaats van opnieuw te verzenden op een trigger die al gesloten is.
Hoe schrijf je een beschrijving die een lijst oplevert?
Schrijf hem als een zin die een collega zou begrijpen en annoteer hem daarna. Benoem de attribuutvoorwaarden en de bewijsvoorwaarden. Benoem voor elke bewijsvoorwaarde het type bron waar hij zichtbaar wordt en hoe lang het venster open blijft.
Een uitgewerkt voorbeeld maakt het concreet. "Bedrijven in jouw regio, in de zakelijke dienstverlening, met tien tot vijftig medewerkers, die de afgelopen dertig dagen een vacature voor een eerste verkoper hebben geplaatst." De attributen zijn de regio, de branche en de grootteklasse. Het bewijs is de vacature, zichtbaar op vacaturesites, met een venster van dagen in plaats van maanden. Een filter op functietitel vindt een salesvacature, maar het woord "eerste" zit in geen enkel filter, en juist dat woord maakt het bedrijf de moeite van een bericht waard. De openingszin volgt uit de bewijsvoorwaarde, en de salesleider die vraagt waarom een bedrijf op de lijst staat, krijgt een gedateerd antwoord.
Vergelijk dat met "middelgrote bedrijven die klaar zijn om te kopen". De zin is even lang, maar noemt geen bewijs, geen brontype en geen datum. Die briefing komt terug als filteruitvoer en ziet er precies zo uit als de vorige.
Waar past Freelvy?
Freelvy is een AI-verkoopplatform dat je gebruikt zoals je ChatGPT of Claude gebruikt. Je schrijft de beschrijving in één prompt, in gewone taal en inclusief de bewijsvoorwaarde. De agent doorzoekt dan op het moment van de vraag 40+ realtime bronnen (kaarten, officiële handelsregisters, vacaturesites, webwinkels, advertentiebibliotheken) in plaats van een opgeslagen momentopname te filteren. Hij verrijkt elke rij met geverifieerde contacten via cascades van providers (zes providers voor e-mail, negen voor telefoon), en een rij die de verificatie niet doorstaat, wordt nooit geleverd en nooit gefactureerd. Zoeken, verrijken en sequences gebeuren in één thread, zodat het bewijs dat een bedrijf kwalificeerde vast blijft zitten aan het bericht dat het noemt. Plannen beginnen bij €49 per maand voor 1.500 credits, met onbeperkt veel teamleden en zonder verplichting.
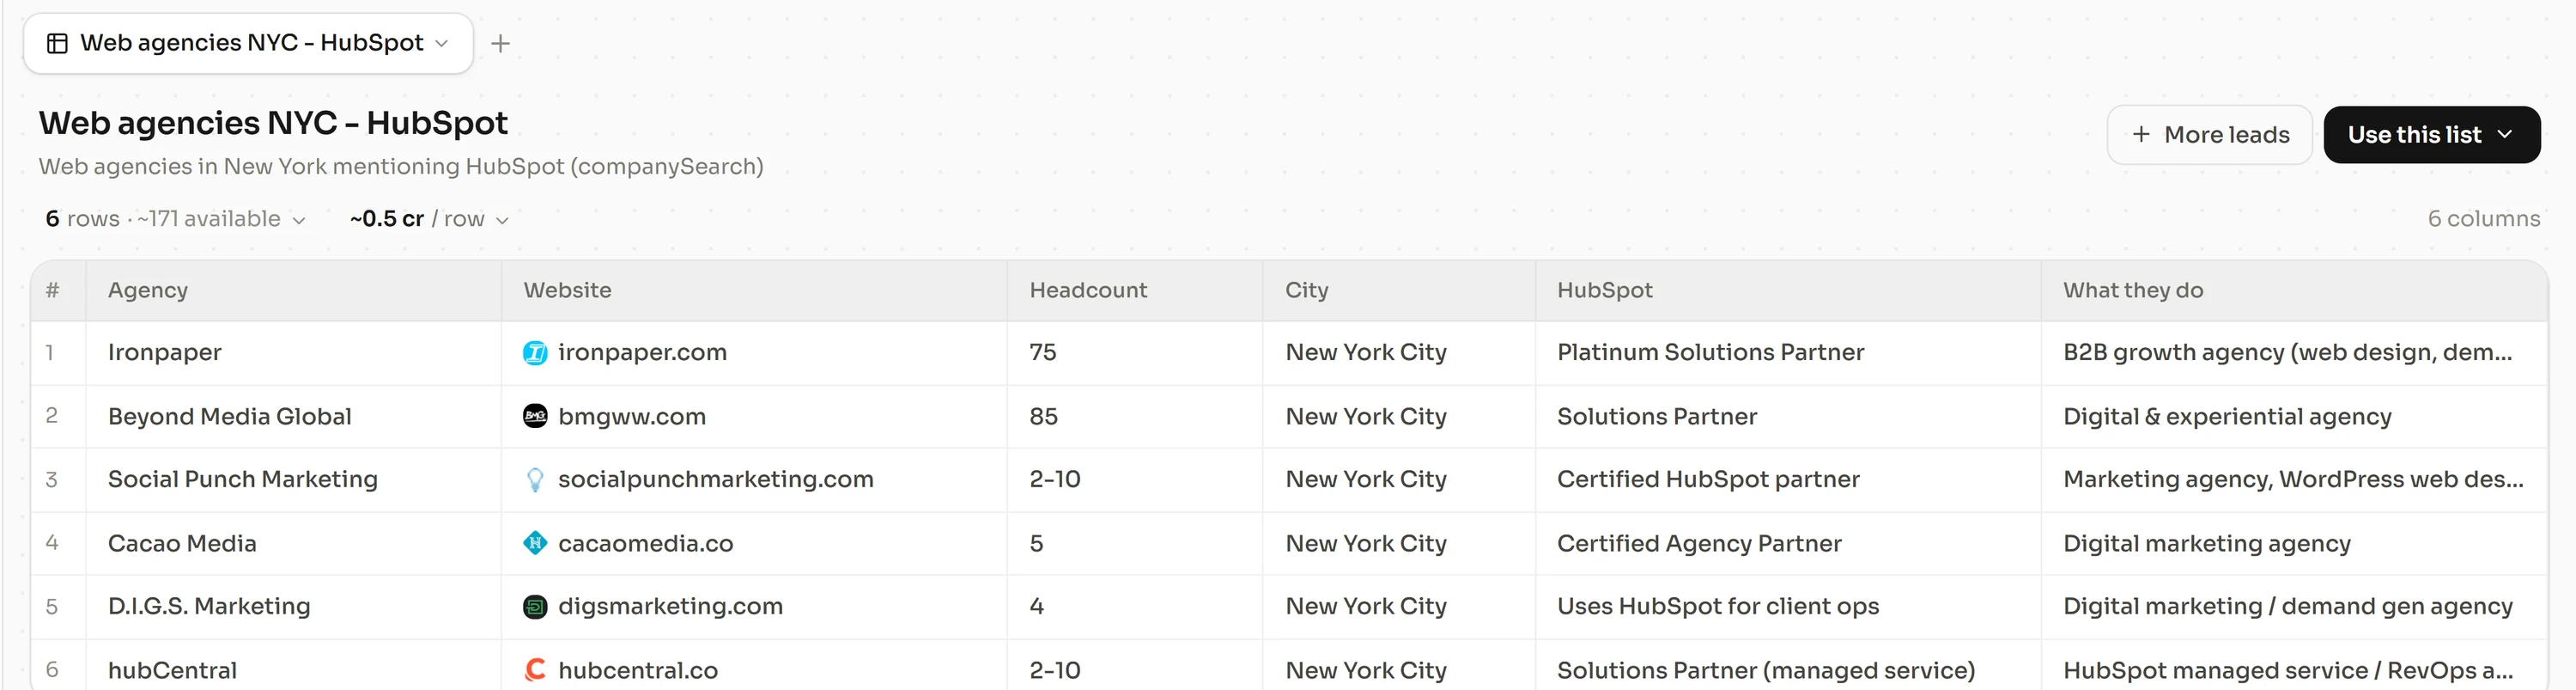
De geannoteerde zin uit de vorige sectie is precies het soort prompt dat Freelvy ongewijzigd verwerkt. De regio, de branche en de omvang beschrijven het bedrijf, en de eerste verkoper is het bewijs dat vacaturesites tonen. Je kunt 7 dagen gratis proberen, zonder creditcard, op freelvy.com.
Hoe we dit hebben gecontroleerd
We hebben elke pagina onder Bronnen gelezen op 23 september 2026. Waar een platform eigen documentatie publiceert, hebben we die gebruikt, namelijk het helpcentrum van LinkedIn voor matchpercentages en het minimum van 300 leden, de API-referentie van Apollo voor zijn filters, en de pagina van HubSpot voor de herkomst van het percentage van 2,1 procent. De illustratie met 400 contacten en de tabel met samengesteld verval zijn onze eigen berekeningen op basis van die gepubliceerde cijfers.
FAQ
Waarom kan ik mijn ICP-lijst niet met filters bouwen?
Omdat de meeste filters beschrijven wat een bedrijf is en niet wat het onlangs deed. Merit Data noemt branche, grootte en functietitel in 2026 noodzakelijk maar bij lange na niet voldoende. Sommige databases filteren inmiddels op werving, technologieën en financiering, maar de specifieke voorwaarde van een briefing, zoals een eerste verkoper, heeft zelden een veld.
Hoe maak ik van een beschrijving in gewone taal een lijst?
Splits hem in een attribuutlaag en een bewijslaag. Houd de attributen zo ruim als je kunt verantwoorden, want elk extra filter verkleint de pool vóór de kwalificatie. Voeg een of twee gedateerde, controleerbare bewijzen toe die waar moeten zijn en neem dan de doorsnede van beide. Het bewijs is ook je openingszin.
Welke bronnen tonen wat een bedrijf nu doet?
Denk in brontypen in plaats van namen. Het officiële handelsregister bevat inschrijvingsdata, rechtsvorm, opgegeven activiteit en gedateerde deponeringen. Vacaturesites tonen wervingsintentie. Kaartvermeldingen tonen nieuwe vestigingen. Webwinkels tonen wat een bedrijf verkoopt en hoe. Openbare advertentiebibliotheken tonen advertentieactiviteit. Reviewplatforms tonen de servicekwaliteit.
Hoeveel bedrijven moet een segment bevatten?
Genoeg om de campagne op het beoogde personalisatieniveau te vullen. Meestal bepaalt dus de bewijslaag de omvang, en niet de attribuutlaag. Tel eerst de attribuutlaag, daarna elke bewijsvoorwaarde afzonderlijk, zodat je weet welke voorwaarde de lijst verkleint voordat je iets versoepelt.
Waarom matchte mijn geüploade doelgroep zo slecht?
Meestal door het bronformaat. Een benchmark van een bureau uit mei 2026 zet LinkedIn-bedrijfslijsten met naam en domein op 90 tot 98 procent en contactlijsten op 70 tot 85 procent bij zakelijke e-mails, terwijl een gids uit maart 2026 60 tot 85 en 30 tot 60 procent geeft. Neem altijd het domein mee, en onthoud dat LinkedIn minstens 300 gematchte ledenaccounts vraagt.
Hoe vaak moet een campagnelijst opnieuw worden gemaakt?
Verifieer contacten op de ochtend van de verzending in plaats van op de dag van het samenstellen, en zoek het bewijs opnieuw op als de campagne opschuift. Bij een gepubliceerd verval van 2,1 procent per maand kost een gat van 90 dagen ongeveer 6,2 procent nauwkeurigheid, en de bewijsvoorwaarde veroudert sneller dan het contact, in dagen voor een vacature en in weken voor een financiering.
Hoe onderbouw ik waarom een bedrijf op een lijst met doelaccounts staat?
Geef elke rij een eigen gedateerd bewijs. Dat is het praktische argument voor een bewijslaag in plaats van een intentiescore zonder bron. Als een salesleider vraagt waarom een bedrijf op de lijst staat, is een deponeringsdatum in het register, een vacaturedatum of een vermelding in een advertentiebibliotheek een antwoord, en een percentage uit een ondoorzichtig model niet.
Bronnen en methodologie
Alle pagina's hieronder zijn gelezen op 23 september 2026. Cijfers zijn in de tekst toegeschreven aan de pagina's die ze publiceerden.
- https://www.meritdata-tech.com/resources-post/blog-how-to-build-icp-strategy-2026
- https://docs.apollo.io/reference/organization-search
- https://www.landbase.com/blog/firmographic-coverage-statistics
- https://www.linkedin.com/help/lms/answer/a420595
- https://www.linkedin.com/help/lms/answer/a423102
- https://www.growthspreeofficial.com/blogs/linkedin-matched-audiences-b2b-2026
- https://benly.ai/learn/linkedin-ads/linkedin-matched-audiences
- https://www.cleanlist.ai/blog/2026-01-22-b2b-data-decay-statistics
- https://www.hubspot.com/database-decay
- https://www.zerobounce.net/email-list-decay
- https://www.lusha.com/blog/b2b-contact-change-report/
- https://instantly.ai/blog/email-list-validation-upload-quality-checks/